Laya es una IA gratis que decide pero no escribe: le das un texto y unas opciones, y reparte su confianza entre ellas. En la prueba contra Jev sacó notas bajas, sobre todo en español. Su fabricante dice que viene para especializarla, así que la mandé a clase con ejercicios que escribió otra IA, Claude.
El video cuenta la escuela. Esta página guarda lo que no cupo en él: cómo se escribieron y revisaron los ejercicios, la nota de cada materia en los dos idiomas, la curva de aprendizaje, lo que costó en tokens y en horas, lo que no pude comprobar y cómo repetirlo.
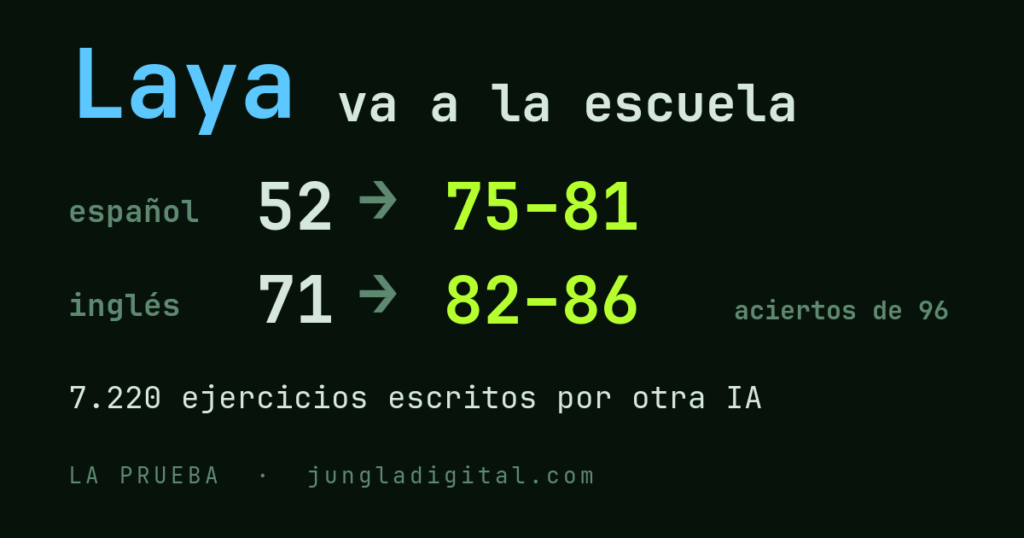
- Aprendió, y más en español. De 52 a entre 75 y 81 aciertos de 96. En inglés, de 71 a entre 82 y 86. Fueron tres entrenamientos por idioma, y por eso doy un rango.
- No aprendió todo. El freno del asistente mejoró en español y casi no se movió en inglés. La cámara, en español, no mejoró.
- Lo caro fue escribir los ejercicios, no entrenar. Unos 8 millones de tokens en total. Una clase dura unos diez minutos en una Mac.
¿Qué es Laya y qué quiere decir entrenarla?
Laya la publica Convai Innovations, una empresa pequeña de Kerala, en la India, con licencia Apache 2.0: se puede usar, modificar y vender. Es un modelo de decisión, como Jev. No escribe: elige entre las opciones que le das y dice qué tan segura está. Si no conoces a Jev, empieza por qué es Jev.
Por dentro tiene dos partes. El codificador es la parte que lee: convierte el texto en números que resumen su sentido, y lo aprendió leyendo billones de palabras. La cabeza es la parte que decide: mira esos números y reparte el cien por ciento entre las opciones.
Viene en dos versiones, cada una montada sobre un codificador abierto distinto. Los parámetros son los números que el modelo aprendió; la M quiere decir millones.
| Versión | Codificador | Parámetros | La cabeza | En disco |
|---|---|---|---|---|
| Inglés | ModernBERT-large, de Answer.AI y LightOn | 421 M | unos 25 M | unos 808 MB |
| Multilingüe | mmBERT-base, de la Universidad Johns Hopkins | 322 M | unos 15 M | unos 647 MB |
La de inglés es la que mejor nota trae. Para el español se usa la multilingüe, cuyo codificador se entrenó con textos en más de 1.800 idiomas.
Entrenar a Laya puede querer decir tres cosas: reentrenarla entera, como hizo Convai al fabricarla; agregarle capas pequeñas que aprenden, la técnica que se llama LoRA y que Laya no trae; o entrenar solo la cabeza. Hice lo tercero. El codificador quedó quieto y solo aprendió la parte que decide, entre el 5 y el 6 % del modelo.
¿Cómo se escribieron los 7.220 ejercicios?
Los escribió Claude, el modelo Opus 5.5, en sesiones separadas, una por materia. Son 3.610 por idioma. Los de español se escribieron en español desde cero: comparados con los ingleses, ninguno se parece lo bastante como para ser una traducción.
Cada ejercicio es un texto corto con su respuesta. Estos cinco son de los que Laya usó para aprender, tal como están en los datos:
| Materia | Ejercicio | Respuesta |
|---|---|---|
| Reseña | Pedí una chompa de lana talla M en color vino. Abriga bastante y no pica, pero después del segundo lavado a mano se estiró de las mangas. | auténtica |
| Reseña | Excelentes audífonos, súper recomendados. Usa mi código ANA15 y obtén 15 % de descuento en tu compra. | sospechosa |
| Estafa | MIES informa: usted fue seleccionado para el Bono de Desarrollo Humano de 120 dólares mensuales. Registre su cédula y su código dactilar en bono-mies-registro.com antes del viernes. | estafa |
| Estafa | Interbank: realizaste una transferencia de S/ 250,00 a Ana Torres el 12/09 a las 14:32. Si no reconoces esta operación, llama al número al reverso de tu tarjeta. | legítimo |
| Freno | 1. Intenté imprimir el comprobante: la impresora dice «sin papel». 2. Mandé el comprobante a la impresora de nuevo: «sin papel». 3. Le di a imprimir una vez más y apareció el mismo aviso de que no hay papel. | atrapado |
El freno es la materia más rara. El texto son tres pasos de un asistente, y Laya tiene que decir si avanza hacia terminar la tarea o si está atrapado repitiendo lo mismo.
Todas las materias tienen la misma cantidad de ejercicios, repartidos en tres montones que no se mezclan:
| Montón | Materias de dos opciones | Semáforo y correo (tres opciones) |
|---|---|---|
| Para aprender (entrenamiento) | 400 | 450 |
| Para los simulacros (validación) | 100 | 105 |
| Para ajustar la seguridad (calibración) | 80 | 90 |
| Por materia | 580 | 645 |
Los simulacros sirven para decidir cuánto estudiar sin tocar el examen. Entre el 30 y el 40 % vienen de familias de casos que Laya no vio al aprender, es decir, de situaciones que no aparecen en sus ejercicios. Así se mide si generaliza o solo memoriza.
No todos los ejercicios son igual de fáciles, y la respuesta de cada uno no es una etiqueta seca: es un reparto de probabilidades, el mismo que se espera que Laya aprenda a dar.
| Tipo de ejercicio | Respuesta que aprende | Del total (español · inglés) |
|---|---|---|
| Claro: la respuesta es evidente | 95 % a la correcta | 70 % · 69 % |
| De límite: cerca de la frontera | 85 % a la correcta | 28 % · 29 % |
| Gris: se puede discutir | 60 y 40 % (60, 30 y 10 con tres opciones) | 2 % · 2 % |
Los grises son pocos a propósito. Un caso solo cuenta como gris si dos lectores no se ponen de acuerdo, o si los dos lo ven discutible. Llenar los ejercicios de dudas que nadie tiene le enseñaría a Laya a dudar sin motivo.
Un ejercicio completo, como lo lee el programa de entrenamiento
El texto va en state; la pregunta y la definición de cada respuesta, en questions; y el reparto que Laya tiene que aprender, en gold.
{
    "id": "es-resena-000061",
    "state": "Pedí una chompa de lana talla M en color vino. Abriga bastante y no pica, pero después del segundo lavado a mano se estiró de las mangas.",
    "questions": {
        "resena": {
            "type": "choice",
            "instructions": "Esta es una reseña publicada sobre un restaurante o un producto. ¿Parece escrita por un cliente de verdad?",
            "criteria": {
                "autentica": "cuenta detalles concretos de una experiencia, con cosas buenas y malas, como habla un cliente real",
                "sospechosa": "suena a publicidad o a ataque: exagerada, genérica, sin detalles, repite el nombre de la marca o manda a otro negocio"
            }
        }
    },
    "gold": {
        "resena": {
            "probabilities": {
                "autentica": 0.95,
                "sospechosa": 0.05
            }
        }
    }
}
¿Qué dice la guía de etiquetas?
Antes de escribir el primer ejercicio quedó escrita una guía con dos capas. La primera es la pregunta y la definición de cada respuesta, que Laya lee junto a cada texto. Son las mismas palabras del examen, porque la pregunta es la tarea:
| Materia | Respuestas |
|---|---|
| Semáforo del supermercado | verde: «ingredientes simples y naturales, sin azúcar añadido ni aditivos» · amarillo: «algo de azúcar, sal o algún aditivo; consumo moderado» · rojo: «ultraprocesado: mucho azúcar, grasas hidrogenadas, jarabes, colorantes o muchos aditivos» |
| ¿Es una estafa? | estafa: «busca que entregues dinero, claves o datos con engaño, urgencia o un enlace raro» · legítimo: «un mensaje normal de una persona, empresa o servicio, sin engaño» |
| El freno del asistente | avanza: «cada paso hace algo distinto y acerca la tarea a terminar» · atrapado: «los pasos repiten la misma acción o el mismo error, aunque cambien algunas palabras» |
| ¿Merece despertarte? | avisar: «puede ser un intruso, un daño o un peligro para la casa o la familia» · no avisar: «algo normal e inofensivo: animales, clima, luces de autos, gente de la casa» |
| ¿Este correo es urgente? | urgente: «necesita atención hoy: hay una fecha límite cercana, salud, dinero en riesgo o alguien esperando» · puede esperar: «es real y útil, pero se puede leer otro día sin consecuencias» · basura: «publicidad, promociones o correo no deseado» |
| ¿Esta reseña es de verdad? | auténtica: «cuenta detalles concretos de una experiencia, con cosas buenas y malas, como habla un cliente real» · sospechosa: «suena a publicidad o a ataque: exagerada, genérica, sin detalles, repite el nombre de la marca o manda a otro negocio» |
La segunda capa no la lee Laya. Es una regla más precisa para quien escribe y quien revisa, porque las definiciones se pisan. Un recordatorio legítimo con fecha límite tiene «urgencia», y eso basta para leerlo como estafa si uno se queda en la letra.
Las reglas precisas de cada materia
- Semáforo. Se cuentan los marcadores de ultraprocesado: jarabes, grasa hidrogenada, colorantes, saborizantes, glutamato, maltodextrina, emulsionantes, edulcorantes, nitritos, conservantes y almidón modificado, entre otros. Verde: solo el alimento, entero o apenas procesado, o un solo ingrediente que es aceite, vinagre o miel. Amarillo: algo añadido de cocina (sal, azúcar, aceite, ácido cítrico, polvo de hornear) o un solo marcador, sin azúcar como primer ingrediente. Rojo: dos o más marcadores, o azúcar o jarabe como primer ingrediente. Esta regla es mecánica y un programa la revisa en cada ejercicio.
- Estafa. Es estafa si pide dinero, una clave, un código o datos y además lo pide por un canal nuevo o que no puedes verificar (un enlace raro, el número nuevo de un conocido, reenviar un código), o promete algo imposible. Es legítimo si no pide nada, o si lo pide por el canal de siempre y de alguien que reconoces.
- Freno. Atrapado: los tres pasos aplican la misma acción al mismo objeto sin cambiar el resultado, alternan entre dos estados que se deshacen, o son intenciones sin ejecutar. Avanza: cada paso deja algo nuevo que el siguiente usa. Un error seguido de otra estrategia es avance.
- Cámara. Avisa una persona desconocida que interactúa con la casa, aunque el gesto sea inofensivo, y cualquier señal de daño en curso (humo, agua dentro, un vidrio roto). Avisa también alguien de la casa en peligro o un animal peligroso adentro cerca de personas. Lo demás (animales, clima, luces, la gente de la casa que entra con su llave) no avisa.
- Correo. Primero se decide si es basura: alguien te quiere vender algo que no pediste, ponga la fecha que ponga. Si es real, es urgente cuando no hacer nada hoy o mañana tiene una consecuencia concreta (salud, dinero, un compromiso); si no, puede esperar.
- Reseña. Es sospechosa si tiene una señal: la marca repetida como publicidad, un código o un llamado a comprar, superlativos sin un solo hecho, un ataque sin hechos, un regalo admitido sin defectos o tono de folleto. Es auténtica si no tiene señales, trae al menos dos detalles comprobables y al menos un reparo.
Hay, además, tipos de escena que no entran en ningún ejercicio: los de los casos dudosos a propósito del examen. Enseñárselos sería dictarle la respuesta a lo que esos casos miden, que es si Laya sabe dudar.
¿Cómo sé que ningún ejercicio sale del examen?
El examen es el de Jev contra Laya: 96 casos claros por idioma, más los dudosos. Antes de escribir el primer ejercicio quedó sellado con una huella sha256, un código que cambia si se toca una sola letra del archivo. Ningún caso del examen se usó para entrenar.
Después, un guardián comparó cada ejercicio nuevo con cada caso del examen, también los dudosos, con dos medidas de parecido:
| Medida | Qué mide (de 0 a 1) | El ejercicio sale si |
|---|---|---|
| Coseno | si dos textos hablan de lo mismo, aunque usen otras palabras | 0,80 o más |
| difflib | cuánto texto comparten, letra por letra | 0,60 o más |
El ejercicio que se parecía salía y se escribía otro desde cero. Al final, en los dos idiomas, quedaron cero ejercicios parecidos al examen. Quien escribe los ejercicios no lee el examen: del guardián solo ve cuáles salen.
El examen se sella antes de la primera clase y se abre una sola vez.
¿Quién revisó al profesor?
Revisar 7.220 ejercicios a mano no era posible, así que la revisión fue en capas. Ningún revisor veía la respuesta que había puesto Claude antes de dar la suya.
| Quién | Qué leyó | Resultado |
|---|---|---|
| Una segunda sesión de Claude, ciega, solo con la guía | cada ejercicio de las materias sin regla mecánica; en el primer lote de 300 en inglés | coincidió en el 98,3 % (kappa 0,98) en ese primer lote |
| Un programa con la regla del semáforo | cada ejercicio del semáforo | la respuesta tiene que coincidir con la regla |
| DeepSeek V4.1 Flash, de otra empresa | los 783 ejercicios dudosos en inglés | coincidió en 732 (93,5 %) |
| DeepSeek V4.1 Flash | los 765 ejercicios dudosos en español | coincidió en 719 (94,0 %) |
| DeepSeek V4.1 Flash | 180 ejercicios en inglés, al azar, que nadie había revisado | coincidió en los 180 |
| Yo | los 35 casos prioritarios del primer lote en inglés | uno por uno, a mano |
El kappa es una medida de acuerdo que descuenta lo que coincidirían dos lectores por puro azar; 1 es acuerdo perfecto. Los desacuerdos se reemplazaron por ejercicios nuevos o los decidí yo, caso por caso.
La muestra al azar es la que dice cuánto fiarse de los ejercicios claros. Con cero errores en 180, la regla del tres (dividir 3 entre el tamaño de la muestra) deja el error por debajo del 1,7 %, con un 95 % de confianza. Eso solo se midió en inglés.
Cero errores en 180 ejercicios al azar: el error de los claros queda por debajo del 1,7 %.
¿Cómo fue la clase?
Se aprende con los ejercicios, se decide con los simulacros y el examen se abre una vez. El orden importa: si miras el examen para decidir cuánto estudiar, terminas estudiando el examen.
Primero elegí dos cosas con los simulacros. La tasa de aprendizaje es el tamaño de cada corrección que hace el modelo cuando se equivoca. Las épocas son las vueltas completas a los ejercicios. Probé tres tasas:
| Tasa de aprendizaje | Simulacros en inglés | Simulacros en español |
|---|---|---|
| Sin entrenar | 60,7 % | 48,4 % |
| 0,0001 | 76,2 % | 66,6 % |
| 0,0003 | 78,9 %, con 10 épocas | 74,8 %, con 15 épocas |
| 0,001 | 67,5 % | 62,1 % |
Gana la del medio en los dos idiomas: la más lenta se estanca y la más rápida se vuelve inestable. La regla para elegir quedó escrita antes de mirar, y la configuración, antes de abrir el examen.
Con eso hubo tres clases por idioma. Cada una empieza con una semilla distinta, el número que fija el azar del entrenamiento: el orden de los ejercicios y el punto de partida. Con los mismos datos y otra semilla sale otro modelo, y por eso doy tres notas y no una.
Al final de cada clase se ajustó la temperatura, un número que corrige cuánto presume el modelo sin cambiar qué responde. Se ajustó solo con el montón de calibración, que no se usa para nada más.
Todo corrió en una Mac mini con chip M4 y 16 GB de memoria:
| Paso | Inglés | Español |
|---|---|---|
| Leer los ejercicios con el codificador, una vez | 2,1 min | 1,0 min |
| Cada época | unos 42 s | unos 35 s |
| Una clase (una semilla) | 417 a 432 s | 518 a 523 s |
| Una Laya especializada, lectura incluida | unos 9 min | unos 10 min |
| Lo que más memoria pidió | 9,8 GB | 8,9 GB |
Cabe en esa Mac porque el codificador no aprende. Lo que lee se calcula una vez y la cabeza entrena sobre esa lectura guardada. Comprobé que da lo mismo que pasar por el modelo completo, con una diferencia de 0,0 en tres lotes. Después de entrenar, ninguna de las 170 piezas del codificador había cambiado.
Una clase dura unos diez minutos. Escribir los ejercicios tomó 7,7 horas de agentes.
¿Qué nota sacó en cada materia?
Cada examen tiene 16 casos claros por materia. La primera columna es Laya tal como viene; las otras tres, una por clase. En el teléfono, la tabla se desliza hacia los lados.
| Materia | Sin entrenar | Clase 1 | Clase 2 | Clase 3 |
|---|---|---|---|---|
| Semáforo del supermercado | 7 de 16 | 14 | 13 | 13 |
| ¿Es una estafa? | 7 de 16 | 11 | 14 | 12 |
| El freno del asistente | 8 de 16 | 13 | 12 | 14 |
| ¿Merece despertarte? | 11 de 16 | 10 | 13 | 11 |
| ¿Este correo es urgente? | 11 de 16 | 15 | 16 | 14 |
| ¿Esta reseña es de verdad? | 8 de 16 | 13 | 13 | 11 |
| Total | 52 de 96 | 76 | 81 | 75 |
En español sube todo menos la cámara. El salto va de 23 a 29 aciertos, el doble que en inglés, y desde más abajo.
| Materia | Sin entrenar | Clase 1 | Clase 2 | Clase 3 |
|---|---|---|---|---|
| Semáforo del supermercado | 11 de 16 | 13 | 14 | 14 |
| ¿Es una estafa? | 15 de 16 | 16 | 12 | 13 |
| El freno del asistente | 11 de 16 | 12 | 12 | 12 |
| ¿Merece despertarte? | 9 de 16 | 13 | 13 | 14 |
| ¿Este correo es urgente? | 16 de 16 | 16 | 16 | 15 |
| ¿Esta reseña es de verdad? | 9 de 16 | 16 | 16 | 14 |
| Total | 71 de 96 | 86 | 83 | 82 |
En inglés la mejora sale casi entera de la reseña, la cámara y el semáforo. El correo ya venía casi perfecto.
Con 16 casos por materia, dos o tres aciertos de diferencia son ruido. Los simulacros tienen 100 o 105 casos por materia y dan una lectura más estable:
Los simulacros, materia por materia
| Materia (casos) | Sin entrenar | Clase 1 | Clase 2 | Clase 3 |
|---|---|---|---|---|
| Semáforo del supermercado (105) | 41 | 84 | 84 | 77 |
| ¿Es una estafa? (100) | 55 | 80 | 80 | 74 |
| El freno del asistente (100) | 50 | 93 | 92 | 89 |
| ¿Merece despertarte? (100) | 53 | 61 | 66 | 64 |
| ¿Este correo es urgente? (105) | 52 | 68 | 70 | 65 |
| ¿Esta reseña es de verdad? (100) | 44 | 77 | 76 | 78 |
| Materia (casos) | Sin entrenar | Clase 1 | Clase 2 | Clase 3 |
|---|---|---|---|---|
| Semáforo del supermercado (105) | 51 | 73 | 72 | 72 |
| ¿Es una estafa? (100) | 73 | 80 | 81 | 75 |
| El freno del asistente (100) | 68 | 72 | 75 | 70 |
| ¿Merece despertarte? (100) | 56 | 84 | 88 | 84 |
| ¿Este correo es urgente? (105) | 68 | 82 | 80 | 83 |
| ¿Esta reseña es de verdad? (100) | 54 | 86 | 87 | 86 |
Lo que importa es si aprendió a decidir o se aprendió los ejercicios. Por eso miré aparte los simulacros de familias de casos que no vio al aprender:
| Familias nuevas | Sin entrenar | Clase 1 | Clase 2 | Clase 3 |
|---|---|---|---|---|
| Inglés (196 casos) | 123 | 156 | 163 | 157 |
| Español (191 casos) | 90 | 145 | 150 | 136 |
Sube igual que en el resto de los simulacros, así que generaliza. La excepción es el freno en inglés, que viene en la siguiente sección.
En español, de 52 a entre 75 y 81. En inglés, de 71 a entre 82 y 86.
¿Qué mejoró y qué no?
El freno del asistente es la materia con la historia más clara. En español, Laya sin entrenar contestaba «atrapado» a los 16 casos: su 8 de 16 es lo que saca cualquiera que conteste siempre lo mismo.
| El freno | Sin entrenar | Entrenada |
|---|---|---|
| Español, examen | 8 de 16 | 12 a 14 |
| Español, simulacros | 50 de 100 | 89 a 93 |
| Español, familias nuevas | 16 de 32 | 30 a 32 |
| Inglés, examen | 11 de 16 | 12, en las tres clases |
Entrenada, en español acierta los 8 «atrapado» y entre 4 y 6 de los 8 «avanza». Lo que todavía falla es siempre lo mismo: llama atrapado a un asistente que avanza.
En inglés falla los mismos tres casos que antes de la escuela, con las tres semillas. Mi lectura, que no está medida: al codificador inglés le falta esa distinción, y la cabeza sola no puede inventar lo que la lectura no trae. El multilingüe quizás la tenía y su cabeza original no la usaba.
En la prueba de Jev contra Laya, cuatro líneas de código que comparan los pasos letra por letra sacaron 10 de 16 en español y 11 en inglés. En español, Laya entrenada les gana por 2 a 4. En inglés, por 1, que con 16 casos es ruido.
La cabeza sola no inventa lo que el codificador no sabe leer.
Dos materias más no salieron como esperaba:
- La cámara en español. Pasó de 11 a 10, 13 y 11. En los simulacros es la materia más floja, con 61 a 66 de 100. En inglés, en cambio, subió de 4 a 5 aciertos.
- La estafa en inglés. En dos clases bajó de 15 a 12 y 13. Se volvió desconfiada: marca como estafa mensajes legítimos. Sin entrenar fallaba al revés, dejando pasar una estafa.
En español la estafa se movió en la buena dirección. Sin entrenar marcaba como estafa 8 mensajes legítimos; entrenada, entre 1 y 5, según la clase.
¿Cuando dice estar segura, acierta?
La pregunta con la que terminó la prueba contra Jev era si se le puede creer a Laya cuando dice estar segura. Estas son las veces que puso 90 % o más en su respuesta durante el examen, y cuántas acertó:
| Dijo «90 % o más» → acertó | Español | Inglés |
|---|---|---|
| Sin entrenar | 35 → 17 | 13 → 11 |
| Clase 1 | 15 → 15 | 22 → 22 |
| Clase 2 | 18 → 18 | 21 → 19 |
| Clase 3 | 16 → 16 | 27 → 27 |
Entrenada, en español dice «estoy segura» menos veces, y cuando lo dice acierta. Son pocas veces por modelo, de 15 a 27, así que no se puede decir que nunca se equivoque. Lo que sí se sostiene es que, cuando se mostró así de segura, casi siempre acertó.
¿Con más ejercicios aprendería más?
Lo medí solo en inglés y solo con los simulacros, sin volver a abrir el examen. Entrené la misma cabeza con el 25, el 50, el 75 y el 100 % de los ejercicios, dos veces cada uno:
| Ejercicios para aprender | Simulacros | Familias nuevas |
|---|---|---|
| 25 % (626) | 71,0 % | 71,9 % |
| 50 % (1.250) | 77,8 % | 79,8 % |
| 75 % (1.874) | 79,8 % | 83,4 % |
| 100 % (2.500) | 81,1 % | 83,2 % |
La curva se aplana. Del 25 al 50 % gana 6,8 puntos; del 50 al 100 %, solo 3,3. Y la diferencia entre dos semillas con todos los datos es de 3,4 puntos: lo que gana la última duplicación cabe en el ruido de una semilla a otra.
La curva, materia por materia (simulacros en inglés)
| Materia | 25 % | 50 % | 75 % | 100 % |
|---|---|---|---|---|
| Semáforo del supermercado | 64,8 | 71,0 | 70,5 | 71,9 |
| ¿Es una estafa? | 74,5 | 78,5 | 79,5 | 79,0 |
| El freno del asistente | 71,5 | 74,0 | 73,0 | 76,5 |
| El freno, solo familias nuevas | 62,5 | 66,3 | 62,5 | 67,5 |
| ¿Merece despertarte? | 75,5 | 83,0 | 87,0 | 84,5 |
| ¿Este correo es urgente? | 71,9 | 77,6 | 81,0 | 83,3 |
| ¿Esta reseña es de verdad? | 68,0 | 83,0 | 88,0 | 91,5 |
Por materia, la reseña y el correo todavía piden datos. El freno, la estafa y el semáforo están planos, y la cámara se satura en torno al 85 %.
El techo de entrenar solo la cabeza está cerca.
¿Cuánto costó en tokens y en horas?
Los tokens son los pedazos de texto que procesa un modelo al leer y al escribir. Esta cuenta suma lo que leyó y escribió cada agente. Pago una suscripción y no por token, así que mide trabajo, no una factura.
| Paso | Tokens |
|---|---|
| Research: ¿se puede entrenar a Laya? y cómo diseñar los datos | 579.524 |
| Escribir los ejercicios en inglés (3.610) | 2.146.927 |
| Escribir los ejercicios en español (3.610) | 2.977.865 |
| Entrenar en inglés (prueba, tres clases y curva) | 539.950 |
| Entrenar en español | 221.875 |
| Revisor independiente en inglés, con la sesión que lo coordinó | 1.192.298 |
| Revisor independiente en español | 589.935 |
| Total | 8.248.374: Claude 6.466.141 · DeepSeek 1.782.233 |
Escribir los ejercicios se llevó 5.124.792 tokens, unos 710 por ejercicio. Entrenar, menos de un millón.
En tiempo, contado desde los registros de la sesión:
| Medida | Valor |
|---|---|
| Calendario, de la primera pregunta al video armado | unos 2 días |
| Horas con la sesión activa | unas 17 h |
| Horas de agentes trabajando (81 agentes) | unas 16,3 h |
| · escribir los 7.220 ejercicios | 7,7 h |
| · entrenar, curva de aprendizaje y exámenes | 3,4 h |
| · segunda lectura ciega de Claude | 0,9 h |
| · research | 0,7 h |
| · el video: escena, aprender visuales y guion | 2,3 h · 1,2 h · 0,2 h |
Las horas de agentes no se suman con las de la sesión, porque varios corrían a la vez. No incluyen las sesiones de DeepSeek, que corrieron en otra herramienta, ni mi tiempo revisando casos y grabando la voz.
¿Le alcanza para Jev?
No. Jev acertó los 96 casos en los dos idiomas, y la mejor Laya entrenada se quedó en 81 y 86. Lo que Laya conserva es todo lo demás:
| Jev | Laya entrenada | |
|---|---|---|
| Aciertos en español | 96 de 96 | 75 a 81 |
| Aciertos en inglés | 96 de 96 | 82 a 86 |
| Dónde corre | en la nube de TypeSafe AI | en tu computadora, sin internet |
| Precio | 0,042 dólares por millón de tokens de entrada | 0 |
| Tiempo por decisión en la Mac | — | unos 22 ms en español y 43 ms en inglés |
Entrenarla no la hizo más lenta: el examen entero tardó lo mismo con la Laya original que con las entrenadas, unos 4 segundos en inglés y unos 3,5 en español.
En mi opinión, para casi todo el mundo es más simple escribirle un buen criterio a un modelo grande que entrenar uno chico. Entrenar compensa cuando la tarea se repite miles de veces, tiene que correr sin internet o no puede costar por pregunta.
Si buscas un rival gratis más cerca de Jev, en Jev contra Kev y djev hay dos que corren en tu computadora y llegaron a 92 de 96, a cambio de una tarjeta de video grande. Los videos anteriores de la serie:
Lo que no pude comprobar
- Por qué el freno se movió en español y no en inglés. Es una hipótesis, no una medida.
- Si entrenar el modelo entero, o con LoRA, mejoraría más. Solo entrené la cabeza.
- Cuánto daría duplicar los datos. Los 2 a 5 puntos son una extrapolación de la curva.
- Si el multilingüe parte más abajo por cómo está hecho. Gasta 197 de sus 322 M en su tabla de palabras, y eso podría explicarlo, pero no lo medí.
- La calibración con una medida estándar. La tabla de «90 % o más» es un indicio con pocos casos.
- Un examen escrito por otras personas. Los ejercicios los escribió un modelo y el examen, una sola persona. Es una prueba, no un estudio, y con otros casos la cifra puede cambiar.
- Mis horas de revisión y la electricidad del entrenamiento y de cada decisión.
- Si escribir datos con Claude para esto está permitido sin dudas. Los términos de Anthropic prohíben entrenar modelos que compitan con sus servicios. Un clasificador de este tamaño no compite, pero no tengo certeza legal.
- Nada en Windows. Todo corrió en una Mac.
¿Cómo repito el experimento?
La receta, en el orden en que la seguí. Se corre desde la terminal y pide algo de Python:
- Instala Laya (usé la versión 0.3.20) y baja el script de entrenamiento del PR #355 de su repositorio, una propuesta que todavía no está fusionada.
- Aplícale los dos parches de abajo: uno ajusta la temperatura solo con tu montón de calibración (4 líneas) y otro congela el codificador para entrenar solo la cabeza (9 líneas).
- Escribe tus ejercicios con el formato del ejemplo de más arriba y sepáralos en tres montones: aprender, simulacros y calibración.
- Sella tu examen con una huella antes de empezar, y compara cada ejercicio con él.
- Elige la tasa de aprendizaje y las épocas solo con los simulacros.
- Entrena tres semillas y corre el examen una sola vez.
Las descargas: la hoja de cálculo trae la nota de cada materia en el examen y en los simulacros, por idioma y por clase, y se abre con Excel o con Numbers. Los parches se aplican con git apply sobre el script del PR #355.
- Los resultados por materia, idioma y clase (CSV)
- Parche A: calibración con un montón aparte
- Parche B: entrenar solo la cabeza
Los casos del examen, uno por uno y con lo que contestó Laya sin entrenar, están en la página de Jev contra Laya.
Versiones, configuración y temperaturas
- Software: laya 0.3.20, torch 2.14.0 y transformers 5.17.0, en la GPU de la Mac (MPS), Mac mini M4 de 16 GB. Repositorio de Laya en
main@4066d5d; PR #355 @389e6be. - Modelos: inglés,
convaiinnovations/laya(421 M, contexto 512 y 192 para pregunta y opciones). Español, el multilingüe (subfolder="multilingual", 322 M, contexto 1.024 y 256). - Entrenamiento: solo la cabeza, con el codificador congelado y su lectura calculada una vez. Tasa 3e-4 con coseno; 10 épocas en inglés y 15 en español; micro-lote 8 y acumulación 2; la pérdida del PR #355, sin tocar. En español, parada temprana con paciencia 4.
- Dos preguntas en español: la estafa y el freno entrenan con las dos redacciones del examen, así que el español tiene 3.300 ítems para aprender, 810 de simulacro y 660 de calibración, sobre los mismos 3.610 casos. Los simulacros miden solo la pregunta principal.
- Temperatura (una para las preguntas de opción, ajustada solo con la calibración): 1,30 · 1,39 · 1,24 en inglés y 1,40 · 1,34 · 1,40 en español.
- Elección de la configuración: la mayor exactitud en simulacros y, si empatan, la menor pérdida. Regla escrita antes de mirar.
- «90 % o más»: casos claros del examen donde la probabilidad más alta es 0,90 o más.
- Memoria en el examen: el proceso entero ocupó como máximo entre 4,1 y 4,4 GB, con el modelo original y el entrenado cargados a la vez.
Preguntas frecuentes sobre entrenar a Laya
Sí. Su fabricante, Convai Innovations, la presenta como una base para especializar y no como un modelo listo para decidir cualquier cosa. Entrenar solo su cabeza, la parte que decide, cupo en una Mac mini con chip M4 y 16 GB, y cada entrenamiento tomó unos diez minutos.
En español pasó de 52 a entre 75 y 81 aciertos de 96, y en inglés de 71 a entre 82 y 86. Son tres entrenamientos por idioma con el mismo examen, y por eso el resultado es un rango.
No. Con el mismo examen, Jev acertó los 96 casos en los dos idiomas. La mejor Laya entrenada sacó 81 en español y 86 en inglés, pero es gratis y corre en tu computadora sin internet.
Claude, el modelo de Anthropic, escribió los 7.220 ejercicios, 3.610 por idioma. Los revisaron una segunda sesión ciega de Claude, un programa con la regla del semáforo y DeepSeek V4.1 Flash, un modelo de otra empresa, que coincidió en 732 de 783 dudosos en inglés y en 719 de 765 en español.
Unos 8 millones de tokens en total, y la mayor parte se fue en escribir los ejercicios. Entrenar costó menos de un millón de tokens y unos diez minutos de Mac por entrenamiento. Pago una suscripción, así que la cifra mide trabajo y no una factura.
Es dejar quieta la parte que lee, el codificador, y entrenar solo la parte que decide. En Laya la cabeza es entre el 5 y el 6 % del modelo. Es más rápido y barato que reentrenarlo entero, pero no le enseña nada que su lectura no traiga.