Qué es JEV, en tres frases. Es un modelo de la empresa TypeSafe AI, publicado el 15 de septiembre de 2026, que no genera texto. Le das un estado (un mensaje, un ticket, un documento) y una pregunta con sus respuestas posibles, y te devuelve una de esas respuestas con una probabilidad. Nada de párrafos, nada de JSON que parsear: la salida ya viene con la forma que tú pediste.
Es para quien ya ha llamado a la API de un modelo de lenguaje y ha escrito un try/catch alrededor de un JSON.parse() porque «a veces devuelve markdown». Este modelo existe para quitar ese renglón.
El video de abajo explica cómo funciona y qué cuentan los titulares. Este artículo añade tres cosas que ahí no caben: cada cifra con quién la dice y contra qué la midió, la prueba de 120 casos que le corrimos nosotros después de grabarlo, y la regla para encontrar en tu propio código las decisiones que hoy le estás pidiendo a un modelo que escribe.
200 veces más rápido… ¿que qué?
Las publicaciones en español dieron cuatro cifras distintas para lo mismo: 100×, «200× y 400×», «de 20 a 200», «de 40 a 400». Ninguna decía contra qué. Esta tabla sí. La marca de la última columna es la de la casa: primario es la empresa, independiente es un tercero que midió, secundario es prensa que copia.
| Cifra | Quién lo dice | Contra qué | Marca |
|---|---|---|---|
| 193,6× más rápido, 444,6× más barato | TypeSafe | Un flujo que eligieron ellos, en su propia página de inicio | primario |
| 40×–200× más rápido | TypeSafe | Modelos frontera, «para consultas con forma de System One» | primario |
| ~3× más rápido | classmethod / DevelopersIO | Un clasificador montado con Gemini 3.5 Flash | independiente |
| ~10–11× más rápido | classmethod / DevelopersIO | Un clasificador montado con DeepSeek V4 Flash | independiente |
| 100× · 200× y 400× · 20 a 200 · 40 a 400 | Prensa en español | Sin especificar | secundario |
Las tres primeras filas pueden ser ciertas a la vez, y ése es el punto. Si venías de pedirle esta decisión a un modelo frontera, la mejora es enorme. Si ya habías montado un clasificador con un modelo pequeño y rápido, que es lo que hace cualquiera que se tomó el problema en serio, la mejora ronda las tres veces. Cuál te toca depende de una sola pregunta: qué estabas usando antes.
La letra pequeña del propio primario tiene dos condiciones en una frase: «for the same levels of frontier intelligence for System One shaped queries». De ahí sale la regla de esta casa para hablar de JEV: ningún multiplicador sin su «contra qué».
Lo que medimos nosotros
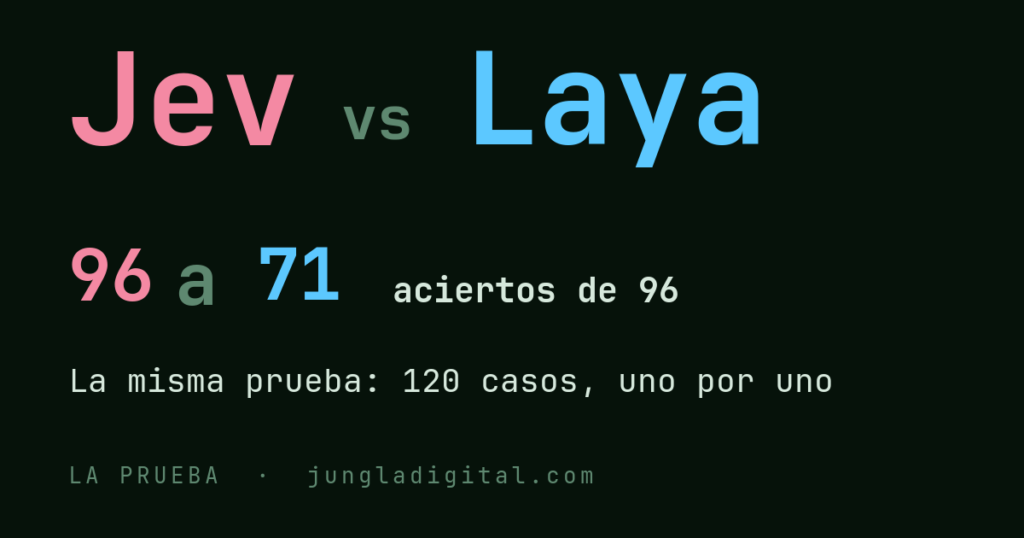
El research del video, del 18 de septiembre, prohibía cualquier frase en primera persona, porque no habíamos ejecutado nada. El 21 de septiembre sí: le corrimos a JEV 120 casos escritos por nosotros antes de llamar al modelo, en español y en inglés, para el versus contra Laya. Seis tareas cotidianas (semáforo de ingredientes, estafa, freno de un agente, cámara de seguridad, correo urgente, reseña falsa), veinte casos por tarea: 16 con respuesta clara y 4 ambiguos a propósito.
| Qué se midió | Español | Inglés |
|---|---|---|
| Aciertos en los 96 casos claros | 96 / 96 | 96 / 96 |
| Latencia mediana por decisión (ida y vuelta por internet) | 680 ms | 569 ms |
| Mediana sin las llamadas colgadas | 661 ms | 565 ms |
| Llamadas colgadas (un intento de conexión que expira) | 14 de 120, ~30,6 s | 12 de 120, ~45,5 s |
| Tokens de entrada, tanda completa | 48.232 | 46.630 |
Coste, según el usage que reporta la API | 0,0020 USD | 0,0020 USD |
| Casos ambiguos en los que dudó (probabilidad máxima < 0,80) | 11 / 24 | 12 / 24 |
| Cuando dijo ≥ 0,9, acertó | 91 / 91 | 90 / 90 |
Cómo se midió: una llamada por caso, en serie, desde una Mac en Ecuador hasta la API de TypeSafe en Estados Unidos, con conexión nueva en cada llamada. La latencia incluye ese viaje, así que los 680 milisegundos son lo que ves desde aquí, no lo que tarda el modelo. Las llamadas colgadas duraban exactamente el tiempo de espera del script más una llamada normal: es la forma de un intento de conexión que expira contra una de las dos IP del servicio y un segundo intento que sí entra. De quién es la pérdida (nuestra red, la ruta o su balanceador) no se pudo establecer.
El coste sale de multiplicar los tokens que reporta la API por el precio publicado, 0,042 USD por millón de tokens de entrada. Unos 402 tokens por decisión, 0,000017 USD cada una; mil decisiones, menos de dos centavos. No lo comprobamos contra una factura.
Dos fuentes coinciden, y eso es lo que importa. La única medición independiente anterior, la de classmethod (40 llamadas, enrutador de modelos), dio una mediana de 0,643 a 0,674 segundos, entre 0,000025 y 0,000027 USD por llamada y 40 aciertos de 40. Lo nuestro sale de otro país, otras tareas y otro idioma. Lo que TypeSafe declara, de 70 a 500 milisegundos, no lo vio ninguna de las dos.
Sobre la calibración, el dato bueno y el malo. Cuando JEV dijo «estoy seguro» (0,9 o más), acertó las 91 veces en español y las 90 en inglés. Pero en los 24 casos ambiguos a propósito dudó en 11; en los otros 13 salió con 0,80 o más. Le puso 0,98 de «sospechosa» a una reseña que decía «Muy bueno, recomendado», porque el criterio que le escribimos decía que sin detalles es sospechosa. Hace lo que le escribes, no lo que querías decir. La tabla caso por caso y el CSV para descargar están en el artículo del versus.
Acierta menos, y no pasa nada por decirlo
En la comparación independiente de classmethod, el acierto de JEV fue del 67,8 % contra el 74,1 % de los modelos con los que lo enfrentó. En los bancos de pruebas propios de TypeSafe sale ese mismo 67,8 %, con un comparable, Terra, en 67,9 %. Así que el resumen honesto es: un poco menos acertado, mucho más rápido y muchísimo más barato. Es un intercambio, y un intercambio se elige sabiendo lo que das.
Nuestro 96 de 96 no contradice ese 67,8 %. Son 96 casos cortos, limpios y escritos por una sola persona; dicen que JEV resuelve bien casos claros bien redactados, no que acierte el 99 % en mensajes reales. Los dos números miden cosas distintas.
La frase «nunca alucina» es de TypeSafe («the model can’t hallucinate», «never makes type errors») y es cierta por construcción. El modelo no puede devolver algo fuera del esquema que le diste. Eso no significa que acierte. Cuando se equivoca, se equivoca eligiendo una de tus opciones. Sean Goedecke lo dijo en los mismos términos, y añadió que la salida estructurada rápida ya se conseguía con prefill y que duda de que haya foso técnico. Un detalle más: TypeSafe no cita ningún banco de pruebas público (nada de MMLU ni equivalentes); evalúa con workflow evals en su propio sitio.
Lo que no puede hacer
Cinco límites, los cinco confirmados contra la documentación oficial o contra quien lo probó.
- No genera texto. Renuncia a la generación de cadenas a cambio de la salida estructurada. Si necesitas un párrafo, no es esto.
- No te explica por qué. Devuelve una opción, probabilidades y una confianza. Sin razonamiento.
- No sirve si no puedes listar las respuestas posibles de antemano. Las opciones las pones tú; si no las sabes, necesitas al que escribe.
- Techo de 255 opciones por pregunta de tipo
Choice, y 64.000 tokens por petición. Ningún artículo en español lo menciona y es justo el límite que te encuentras en producción. - No es para razonar en abierto. Sin cómputo en tiempo de inferencia hay un techo de inteligencia, y el 67,8 % de arriba es una forma de verlo.
Dos más, de la documentación leída el 21 de septiembre: sólo acepta texto, y sobre otros idiomas dice que «se manejan, pero no igual de bien». El español no aparece nombrado. En nuestros 120 casos no se notó.
Cómo encontrar los jueces en tu código
Ésta es la parte que sigue valiendo cuando JEV deje de ser noticia. Un sistema tiene decisiones de dos tipos: las de juez (elegir, puntuar, decir sí o no) y las de escritor (prosa, razonamiento, algo que no anticipaste). Casi todo el mundo tiene jueces contratados como escritores. Para separarlos, tres preguntas en este orden:
1. ¿La respuesta se puede CALCULAR sin ambigüedad?
   SÍ → código normal. Ni juez ni escritor.
        (un modelo aquí añade latencia, coste y
         no-determinismo a cambio de nada)
   NO ↓

2. ¿Puedes ESCRIBIR las respuestas posibles antes de preguntar?
   SÍ → JUEZ. Elige, puntúa o dice sí/no, con probabilidad.
   NO ↓

3. → ESCRITOR. Prosa, razonamiento, o algo que no anticipaste.
La primera pregunta es la que más gente se salta. Si la respuesta es una resta, una tabla o una expresión regular que funciona, meterle un modelo la empeora: añade latencia, coste y una respuesta que ya no es siempre la misma. Es el error más fácil de cometer con esto.
Los jueces ya están en tu código, disfrazados. Casi siempre con una de estas cuatro caras:
| Cómo se ve hoy | Qué es en realidad | Qué le falta |
|---|---|---|
if (texto.includes("gratis")) marcarSpam() | Un juicio metido en una lista de palabras | Criterio. La lista nunca termina de crecer. |
| Una regex validando un campo de texto libre | Un juicio disfrazado de expresión regular | Entender, no coincidir. |
if (score > 0.8) con un número puesto a ojo | Un umbral sin calibrar | Que el 0,8 signifique algo. |
| Un prompt que termina en «responde sólo JSON» | Un juez al que le pediste un ensayo | Quitarle el parser y el try/catch. |
El cuarto es el más común y el que más duele. Si tienes un prompt que termina en «responde únicamente con JSON, sin explicaciones», ya decidiste que querías un juez. Sólo que se lo estabas pidiendo a un escritor, y pagando por cada palabra que no ibas a leer. Lo que hace que un juez sirva en producción es el umbral, más que el acierto: lo seguro se resuelve solo y lo dudoso sube a una persona. Nuestro 91 de 91 por encima de 0,9 es ese umbral, medido.
Disponibilidad y precio, con fecha
A fecha del 18 de septiembre de 2026, tres señales que no encajaban: typesafe.ai ofrecía una lista de espera; OpenRouter lo anunciaba disponible en beta; Cloudflare Workers AI lo listaba como typesafe/jev, con ejemplos en cURL y TypeScript. Por eso el video no dice ni «puedes probarlo hoy» ni «está en lista de espera».
A fecha del 21 de septiembre, nosotros sí lo llamamos, y así: POST https://api.typesafe.ai/v1/systemone, con la clave en la cabecera Authorization: Bearer, el modelo jev-latest (que resolvió a jev-1.13.0) y una pregunta de tipo choice con sus criteria. Un script de Python con la biblioteca estándar, sin SDK. La clave se leyó del Llavero de macOS en memoria y nunca se escribió en un archivo; el porqué está en variables de entorno y API keys, sin llorar. Lo que no comprobamos: si ese día cualquiera podía conseguir una clave. Esta cuenta la tenía.
El precio, leído el 21 de septiembre en la página de modelos: 0,042 USD por millón de tokens de entrada y salida gratis. Los precios de modelos se mueven; si lees esto dentro de unos meses, la cifra que vale es la de esa página, no la de este párrafo.
La serie sobre JEV en el sitio
Este artículo es el primero de tres. Diez casos reales con JEV recorre diez usos de un modelo que solo decide, del semáforo del supermercado al árbitro que frena a un agente atrapado en un bucle, separando lo medido de lo que es una propuesta.JEV contra Laya es la prueba entera de 120 casos, con la tabla caso por caso, el CSV y los scripts para que la repitas con tus propios ejemplos. Y todos los videos del canal, con su descripción y sus capítulos, están en la sección de videos.